

Runc и Curl столкнулись с наплывом ошибок от ИИ
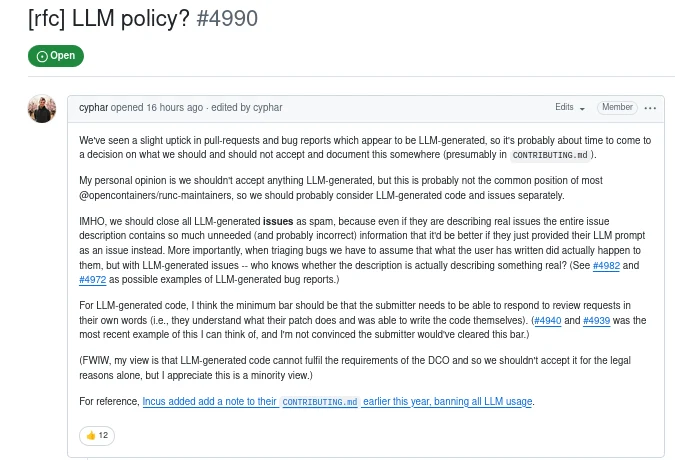
Команда открытого проекта runc столкнулась с увеличением количества pull-request и отчётов об ошибках, сгенерированных искусственным интеллектом (ИИ).
Мейнтейнер проекта opencontainers Алекса Сарай заявил о необходимости выработки правил приема и обработки контента, созданного ИИ, и их документирования.
Разработчики рассматривают несколько вариантов:
Полный отказ от принятия контента, сгенерированного ИИ, или его отдельное рассмотрение.
Закрытие issue, сгенерированных ИИ, как спам, поскольку они часто содержат избыточную и потенциально неверную информацию. Вместо этого предлагается предоставлять промпты, использованные для генерации issue.
При рассмотрении issue, сгенерированных ИИ, разработчики должны учитывать, что описание проблемы может не соответствовать действительности.
В случае с кодом, сгенерированным ИИ, автор должен быть способен объяснить его работу своими словами.
Использование LLM допустимо для перевода, исправления грамматических ошибок, автозаполнения тривиального кода.
Ранее японское сообщество Support.mozilla.org (SUMO) закрылось из-за машинного перевода и перезаписи публикаций, созданных людьми.
Проект Fedora утвердил правила использования ИИ-инструментов в разработке, предусматривающие обязательный человеческий контроль и ответственность разработчика.
ИИ-инструменты помогли исследователю Джошуа Роджерсу обнаружить 50 ошибок в утилите curl, однако автор проекта, Даниэль Стенберг, заявил о прекращении изучения отчётов об уязвимостях, полученных через платформу HackerOne с помощью ИИ, из-за их большого количества и низкой ценности.


