

ChatGPT научился избегать длинных тире: маленькая победа ИИ
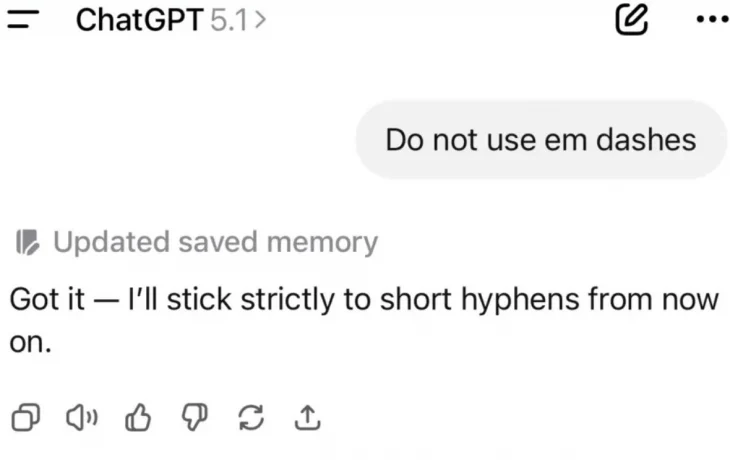
Генеральный директор OpenAI Сэм Альтман сообщил, что чат-бот ChatGPT теперь способен следовать указаниям пользователя и избегать чрезмерного использования длинных тире, которые ранее часто выдавали тексты, сгенерированные искусственным интеллектом.
"Небольшая, но важная победа: если вы попросите ChatGPT не использовать длинные тире, он наконец-то это сделает!" — написал Альтман.
Это заявление вызвало оживлённую дискуссию в сообществе, поскольку пользователи годами пытались настроить чат-бота на соблюдение определённых правил форматирования. Многие выразили мнение, что прогресс в области общего искусственного интеллекта может быть не таким быстрым, как кажется. Один из пользователей X заметил: "То, что потребовалось три года, чтобы научить ChatGPT выполнять простое требование, говорит о слабом контроле и понимании его работы".
Длинное тире, в отличие от дефиса, используется для выделения вводной информации, смены мысли или пояснения.
Проблема чрезмерного использования длинных тире волновала писателей задолго до появления языковых моделей. Ещё в 2011 году Норин Мэлоун в статье для Slate отметила, что авторы злоупотребляют ими "вместо правильного построения предложений".
Авторы, предпочитающие этот знак препинания, столкнулись с тем, что тексты ИИ легко идентифицируются по длинным тире. Некоторые даже утверждают, что ИИ "убивает" эту стилистическую особенность.
Причины этой тенденции до конца не ясны. Существуют предположения, что модели ИИ усвоили эту привычку из-за преобладания длинных тире в текстах XIX века, использованных для обучения, либо из-за особенностей автоматической замены символов в блоге Medium. Возможно также, что в процессе обучения с обратной связью от человека ответы с длинными тире получали более высокую оценку.
Теперь, благодаря пользовательским инструкциям, ChatGPT позволяет установить постоянные настройки для всех разговоров, включая правила форматирования. Тестирование GPT-5.1 показало успешное выполнение просьбы об отказе от длинных тире, однако опыт пользователей по-прежнему различается.
Следование инструкциям в больших языковых моделях основано на изменении статистических вероятностей, а не на чётком выполнении команд. Пользовательская инструкция влияет на распределение токенов, но всё ещё конкурирует с данными, на которых обучена модель.
Вероятно, OpenAI внесла изменения в GPT-5.1, увеличив вес пользовательских инструкций. Однако компания постоянно обновляет модели, корректируя результаты на основе отзывов пользователей и новых данных. Эти обновления могут сводить на нет предыдущие настройки. Исследователи называют это "налогом на выравнивание".


