

GPT-5.1 Thinking High – лидер рейтинга ИИ
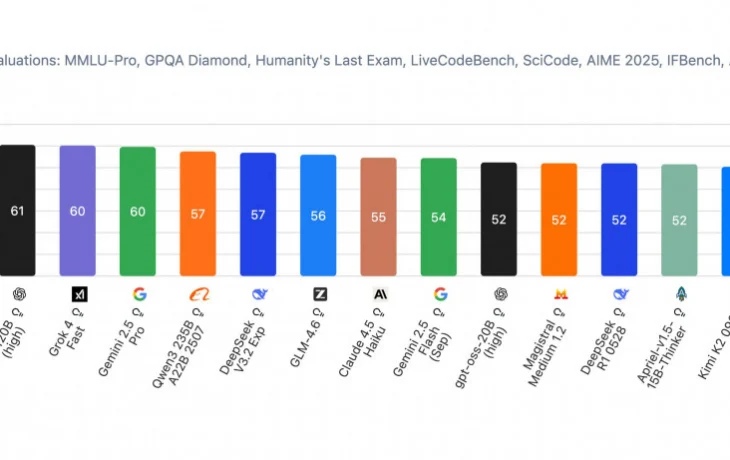
Опубликован обновленный Artificial Analysis Intelligence Index, сводный индекс, оценивающий эффективность ИИ по ряду популярных бенчмарков. Лидером стала GPT-5.1 Thinking High (70 баллов), опередив GPT-5 Thinking High (68 баллов), Kimi K2 Thinking (67 баллов), Grok 4 (65 баллов) и Claude Sonnet 4.5 (63 балла).
Улучшение достигнуто благодаря значительному (на 12 процентных пунктов) прогрессу GPT-5.1 Thinking в бенчмарке TerminalBench, оценивающем агентские возможности модели. Авторы отметили более естественные ответы и экономичный расход токенов: несмотря на аналогичную стоимость API, затраты на прогон бенчмарков снизились с $913 до $859.
Все версии GPT-5.1 продемонстрировали высокие результаты в Design Arena, оценивающем работу ИИ с фронтендом, соперничая с моделями Claude 4.x.
Версия GPT-5.1 Codex для кодинга заняла первое место в SWE-Bench, оценивающем способность ИИ решать задачи программной инженерии на основе задач из GitHub, с акцентом на генерацию патчей для кода.
В тестах OpenAI GPT-5.1 Thinking показала 76,3% в SWE-Bench Verified (500 задач, проверенных программистами). Полная версия SWE-Bench (2000 задач) сложнее для оптимизации ИИ.
В общем, ИИ продолжает развиваться, и скоро мы все будем жить в мире, где роботы будут писать код лучше нас, а мы будем сидеть и удивляться, как же так вышло.


