

Claude Opus 4.5 показал отличные результаты в тестах на интеллект
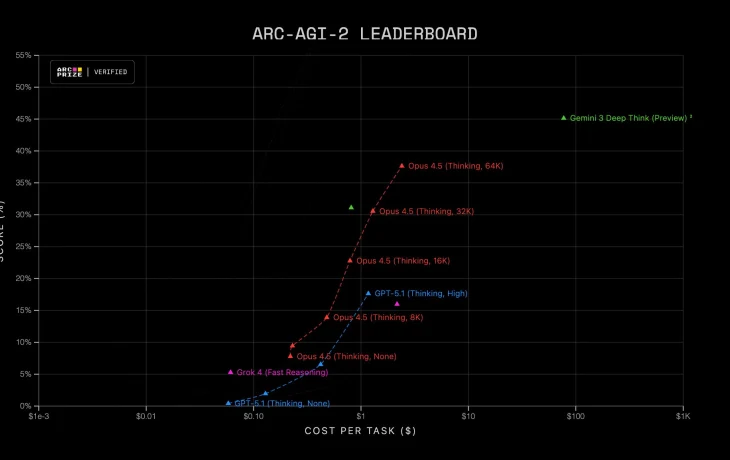
После выхода Claude Opus 4.5, ARC Prize опубликовала результаты модели в бенчмарках ARC-AGI-1 и ARC-AGI-2. В ARC-AGI1 Opus 4.5 показывает 80% с затратами $1,47 на задачу, а в ARC-AGI-2 — 37,64% при стоимости $2,40.
ARC-AGI тестирует способность к абстрактному мышлению и переносу знаний на новые задачи. Модели демонстрируют визуальные головоломки с примерами решения, после чего должны самостоятельно решить аналогичную задачу. Этот тест прост для людей, но сложен для ИИ, требуя навыков переноса знаний, необходимых для работы в динамичной среде.
В ARC-AGI-1 Opus 4.5 приблизилась к человеческому уровню (хотя ARC-AGI-1 считается устаревшим). В более защищенном ARC-AGI-2 Opus 4.5 опередила Gemini 3 Pro (37,64% против ~31%), но отстает от человеческого результата в 66%.
Opus 4.5, флагманская модель Anthropic, превосходит конкурентов от Google и OpenAI в большинстве тестов, в том числе SWE-Bench Verified для оценки навыков программирования. Стоимость использования API снижена в три раза ($5 за миллион входных токенов и $25 за миллион выходных), и модель эффективнее расходует токены, что иногда делает её использование дешевле, чем Claude Sonnet 4.5.


