

DeepSeek V3.2: Открытая модель, превосходящая GPT-5!
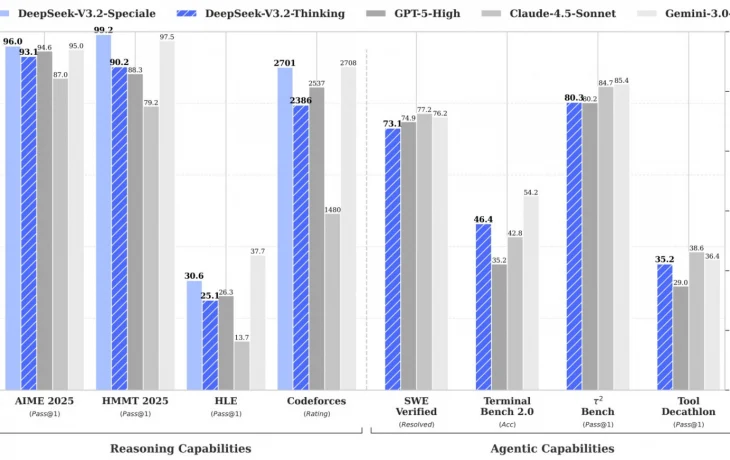
DeepSeek представила новые открытые модели V3.2 и V3.2-Speciale. Базовая версия демонстрирует производительность, сопоставимую с GPT-5, и доступна бесплатно через веб-интерфейс и приложения (API доступно по значительно сниженной цене). Модель Speciale стала первой широкодоступной моделью с открытыми весами, достигшей уровня золотой медали на международных олимпиадах по математике, информатике и в финале чемпионата мира по программированию.
Технический отчет DeepSeek раскрывает три ключевых фактора успеха. Во-первых, DeepSeek Sparse Attention позволяет модели фокусироваться только на 2048 наиболее релевантных токенов из 128 тысяч, значительно снижая вычислительную сложность и стоимость обработки длинных контекстов.
Во-вторых, компания применила агрессивное пост-обучение с использованием обучения с подкреплением (RL), бюджет на которое превысил 10% от стоимости предварительного обучения. Использовалась схема обучения отдельных “специалистов” для различных задач, с последующей дистилляцией их знаний в единую модель и финальным этапом RL.
В-третьих, DeepSeek разработала специализированные данные для обучения агентов, включающие реальные и автоматически сгенерированные среды, а также улучшенное управление контекстом, позволяющее сохранять “мысли” между вызовами инструментов.
Несмотря на достижения, авторы отмечают ограничения модели, связанные с меньшим объемом предварительного обучения и большей потребностью в токенах для достижения уровня ответов Gemini 3 Pro. В будущем планируется уделить больше внимания предварительному обучению.


