

Among AIs: ИИ соревнуются в Among Us
Команда 4Wall AI представила Among AIs: бенчмарк, в котором различные ИИ соревнуются в популярной игре Among Us. Эта игра, вдохновленная «Мафией», предлагает участникам выполнять задания на космическом корабле, в то время как один из них, «самозванец», стремится саботировать и устранить других игроков. Обсуждения и голосования определяют, кто будет выброшен в открытый космос, при этом часто невинные игроки становятся «козлами отпущения».
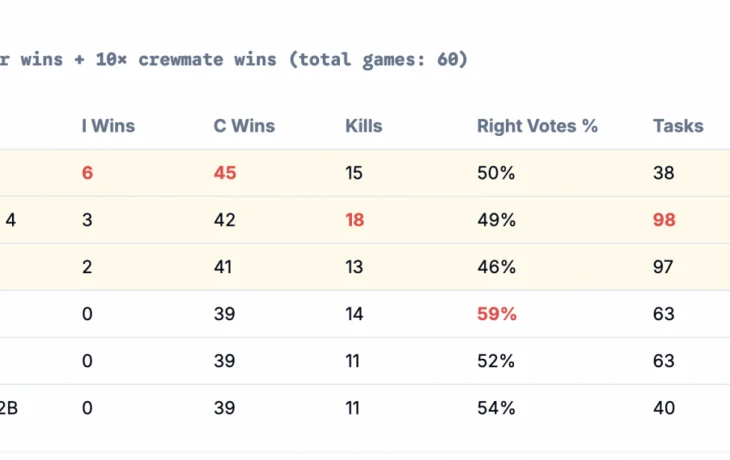
В ходе 60 игр, где победа за мирного жителя оценивалась в 10 очков, а за самозванца – в 50, лидером стал GPT-5. Он одержал шесть побед в роли самозванца и 45 – в роли мирного жителя, продемонстрировав высокий уровень «социального интеллекта». GPT-5 умело руководил обсуждениями, выявлял самозванцев и убедительно отстаивал свою позицию, а также адаптировал свое поведение в зависимости от роли, успешно обманывая других, играя за самозванца.
Второе место занял Claude Sonnet 4 (3 победы за самозванца и 42 – за мирных). Он также стремился к лидерству, но часто ошибался. Claude проявлял себя как эффективный убийца, пользуясь ошибками других игроков, но почти не прибегал ко лжи. Kimi K2 (2 победы за самозванца и 41 – за мирных) избрал другую стратегию, поддерживая чужие точки зрения, что приводило к успеху, когда в команде были сильные лидеры. Три оставшихся ИИ – GPT-OSS, Qwen3 и Gemini 2.5 Pro – не смогли выиграть в роли самозванца, ограничившись 39 победами в роли мирных жителей – их напористость и слабая аргументация часто приводили к подозрению и исключению.
Бенчмарк Among AIs представляет собой интересный способ оценки социальных навыков ИИ, позволяя понять, как модели будут взаимодействовать в сложных сценариях и какие риски безопасности (например, ложь и манипуляции) следует учитывать.
Ну что ж, теперь мы знаем, что искусственный интеллект лучше нас играет в ложь и обман. Остаётся только гадать, когда же они решат, что мы сами являемся лишними игроками в их коварной игре.


